Diffusion Desk

L’IA image et vidéo open source, sourcée chaque jour

Diffusion Desk

L’actu de ComfyUI, Civitai, civitai.red et des nouveaux modèles image et vidéo

Dernière mise à jour 46 actus 33 sources

Image : civitai.com
À la uneModèles

Muse by Stable Yogi v4.0 Extended : un checkpoint photoréaliste pour Krea 2

Le checkpoint le plus téléchargé du mois selon l’API publique de Civitai (filtre SFW) passe en v4.0 « Extended » : textures de peau, de cheveux et de tissu plus réalistes et poses plus naturelles. Il existe en Q8 GGUF (21 oct.), FP8 et INT8 (23 oct.) ; réglages rapides : 8 étapes, CFG 1, Euler.

CheckpointBase : Krea 2Licence : non précisée

À noter : Classement issu de civitai.com/api/v1/models (Most Downloaded, mois, nsfw=false) le 26 oct. La page du modèle date de juin ; la v4.0 est la nouveauté.

Source : Page du modèle sur Civitai
Civitai

Mise à jour hebdo de Civitai : formulaire d’appel, copies de modèles refusées, Flux 3 Video Max

Les appels passent désormais par civitai.com/appeal, et les copies du modèle d’un autre créateur sont refusées ou dépubliées. Le générateur ajoute Flux 3 Video Max (clips de 5 à 20 s, images clés à partir de 10 images maximum), s’ouvre désormais sans connexion, et l’entraînement MOSS est ouvert à tous.

Source : Changelog Civitai

Image : docs.comfy.org
ComfyUI

ComfyUI v0.42.4 ajoute les nœuds partenaires VEED Fabric, Lipsync 2.0 et Mirelo SFX 2.0

Nouveaux nœuds partenaires dans cette version : VEED Fabric 1.0, Lipsync 2.0, Remove Video Background, Clean Audio et Mirelo SFX 2.0. Elle ajoute aussi un mode de réflexion « ultra » pour Krea 3.

À noter : Confirmé uniquement dans le changelog de la documentation. Le 26/10/2026, la page des releases GitHub indiquait encore v0.42.1 comme dernière version.

Source : Changelog de la doc ComfyUI

Image : huggingface.co
Modèles

MiniMax H3 Singularity v2 : fichiers élagués int8, w6a8 et w4a8 pour ComfyUI

WAS a reconditionné la version ref2va v2 de Singularity, un fine-tune communautaire de MiniMax H3, en fichiers élagués et quantifiés (int8 21,0 Go, w6a8 16,0 Go, w4a8 11,8 Go), au format des versions élaguées officielles de ComfyUI. Ils se chargent avec le nœud Load Diffusion Model. La fiche publie des comparaisons PSNR avec la version bf16.

Checkpoint vidéoBase : MiniMax-H3 (fine-tune Singularity)Licence : MiniMax H3 Community License

Source : Fiche du modèle sur Hugging Face

Image : huggingface.co
Modèles

LoRA PTD pour MiniMax-H3 : référence vers vidéo en 8 et 4 étapes

L’équipe IA de contenu de Taobao a distillé la tâche Ref2VA de MiniMax-H3 (image de référence vers vidéo et audio) par Parametric Trajectory Distillation, et publie des LoRA d’accélération en 8 et 4 étapes, avec un adaptateur par étape. Un dépôt jumeau, PTD-RefAsymOPD (22 oct.), ajoute des versions en 8 et 6 étapes, plus nettes et plus réalistes.

LoRA vidéoBase : MiniMax-H3Licence : MiniMax H3 Community License

À noter : Les gains de qualité de RefAsymOPD sont annoncés par les auteurs.

Source : Fiche du modèle sur Hugging Face

Image : huggingface.co
Modèles

Kromoss : un fine-tune complet de MOSS-Image, avec des LoRA turbo en 8 étapes

Le compte lodestones a publié Kromoss, un fine-tune complet de MOSS-Image-Base en 1024 px, entraîné sur 704 000 images. Il remplace directement MOSS-Image-SFT et inclut deux LoRA turbo (8 étapes, CFG 1) distillées avec DMD et DMD2.

CheckpointBase : MOSS-Image-BaseLicence : Apache 2.0

À noter : Publié deux jours après les poids de MOSS-Image ; les comparaisons de qualité de la fiche sont celles de l’auteur.

Source : Fiche du modèle sur Hugging Face

Image : github.com
ComfyUI

ComfyUI v0.42.0 prend en charge MOSS-Image en natif

MOSS-Image tourne désormais en natif, avec le text-to-image et des prompts de mise en page définis par des boîtes englobantes. La version accélère aussi Qwen 3.x, ajoute les embeddings Qwen3.5 et des tests sur Linux ARM, et passe le frontend en 1.55.18. La v0.42.1 (19 oct.) a corrigé des plantages dans les templates MOSS.

Source : Releases GitHub de ComfyUI

Image : huggingface.co
Modèles

Bria Fibo 2.0 Dev : un seul modèle ouvert pour générer et éditer

Fibo 2.0 Dev de Bria est la base complète, non distillée, de la nouvelle génération FIBO : un seul modèle pour le text-to-image et l’édition par instructions (avec masque et multi-références), entraîné uniquement sur des données sous licence. Il conserve les légendes structurées VGL et annonce un meilleur rendu du texte, des textures et de l’anatomie ; une variante Edit Turbo en peu d’étapes existe aussi.

Modèle de baseBase : FIBO 2.0 (nouvelle base)Licence : CC BY-NC 4.0 (accès sur demande)

À noter : Licence lue dans les métadonnées du dépôt (non commerciale). Le classement « n° 1 en édition parmi les modèles à poids ouverts » est revendiqué par Bria, qui cite Artificial Analysis. ComfyUI v0.42.3 a ajouté des nœuds partenaires Bria FIBO 2.0.

Source : Fiche du modèle sur Hugging Face

Image : civitai.com
Civitai

MOSS Image arrive sur Civitai : prompts longs et mise en page en JSON

Le modèle text-to-image à poids ouverts de 5 Md de paramètres d’OpenMOSS est disponible dans le générateur, en versions SFT et Base. Il accepte des prompts jusqu’à 4K tokens, gère la mise en page en JSON et produit des images de 512 px à 2K. Les poids sont sous licence Apache 2.0, et l’entraînement de LoRA est disponible dans Training Studio.

Source : Article Civitai

Image : huggingface.co
Modèles

FastH3-QAD-v2 : la vidéo MiniMax H3 en 8 étapes et en NVFP4 sur un seul GPU

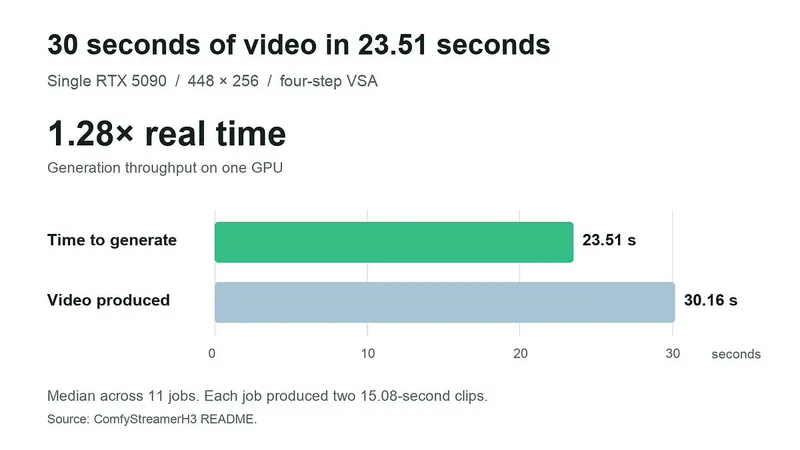
FastVideo a publié un modèle vidéo et audio en 8 étapes, aux poids NVFP4 entraînés par distillation consciente de la quantification (QAD) face à un modèle enseignant BF16. Il vise un seul GPU Blackwell (RTX 5090, RTX PRO 6000) ou un DGX Spark et utilise l’attention clairsemée par blocs VSA.

Checkpoint vidéoBase : FastH3 8 étapes v2 (MiniMax H3)Licence : non précisée

À noter : La fiche ne précise pas la licence (« other ») ; la base MiniMax H3 est déduite du nom FastH3 et de la fiche.

Source : Fiche du modèle sur Hugging Face

Modèles

La LoRA Lenovo UltraReal arrive en version MOSS Image

La LoRA de style photoréaliste de Danrisi, la plus téléchargée du mois selon l’API publique de Civitai (filtre SFW), reçoit une version v1.0 pour MOSS Image le 17 oct., après celles pour Qwen 2.1 (22 sept.) et Krea 2. Le même auteur a aussi publié des versions MOSS de NiceGirls UltraReal et 2000s Analog Core.

LoRABase : MOSS ImageLicence : non précisée

À noter : Pas d’image : les aperçus de la version MOSS ne sont pas classés tout public sur Civitai. Classement issu de l’API publique le 26 oct.

Source : Page du modèle sur Civitai
Image : civitai.com
Civitai

Flux.3 Klein sur Civitai : édition avec jusqu’à 10 références

Flux.3 Klein de BFL (5,6 Md de paramètres, poids ouverts, versions distillée et Base) est disponible dans le générateur pour le text-to-image et l’édition avec jusqu’à 10 images de référence. Les fichiers int8 tournent sur un GPU de 8 Go. FLUX 3 Image, accessible uniquement par API, est disponible depuis le 2 oct.

Source : Article Civitai

Image : civitai.com
Modèles

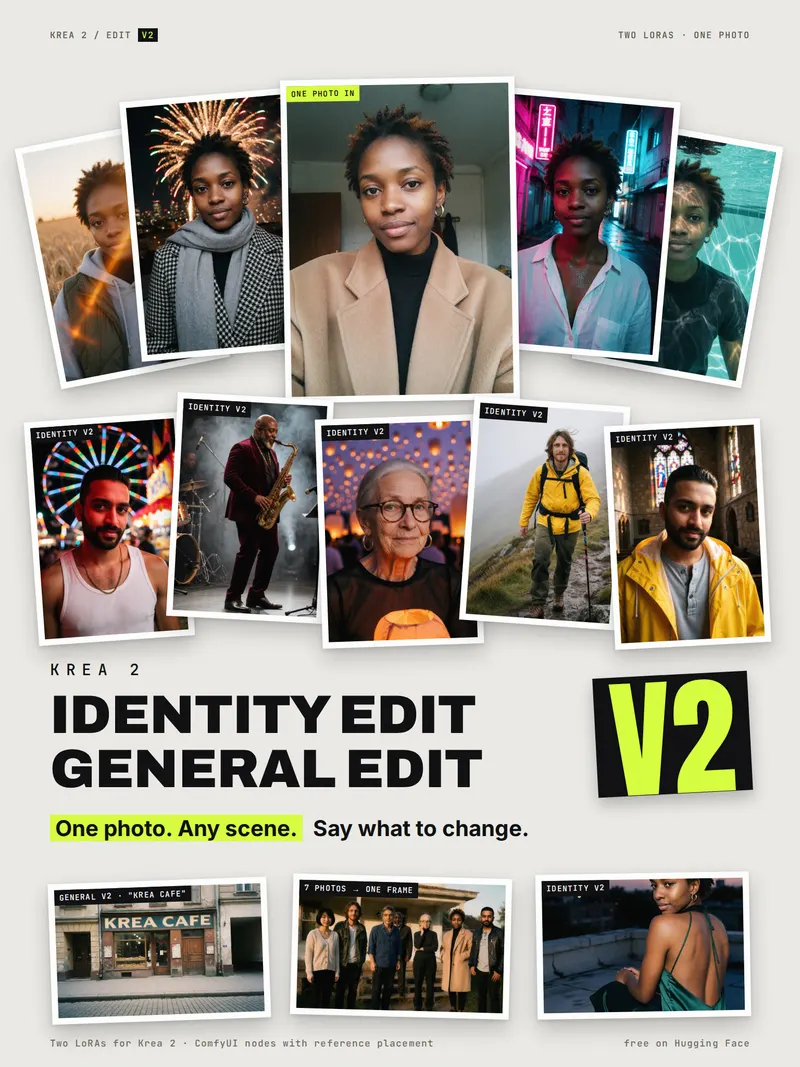
Krea 2 Identity Edit V2 : une photo en entrée, la même personne partout en sortie

Cette LoRA Civitai pour Krea 2 se décline désormais en deux LoRA : Identity Edit V2 place la personne d’une photo de référence dans n’importe quelle scène, pose ou tenue avec une meilleure ressemblance, et General Edit V2 exécute des retouches décrites en langage courant : supprimer des objets, changer l’éclairage ou les couleurs, remplacer l’arrière-plan.

LoRABase : Krea 2Licence : non précisée

À noter : Projet amateur d’une seule personne. Civitai n’indique pas de nom de licence, seulement des autorisations d’usage.

Source : Page du modèle sur Civitai
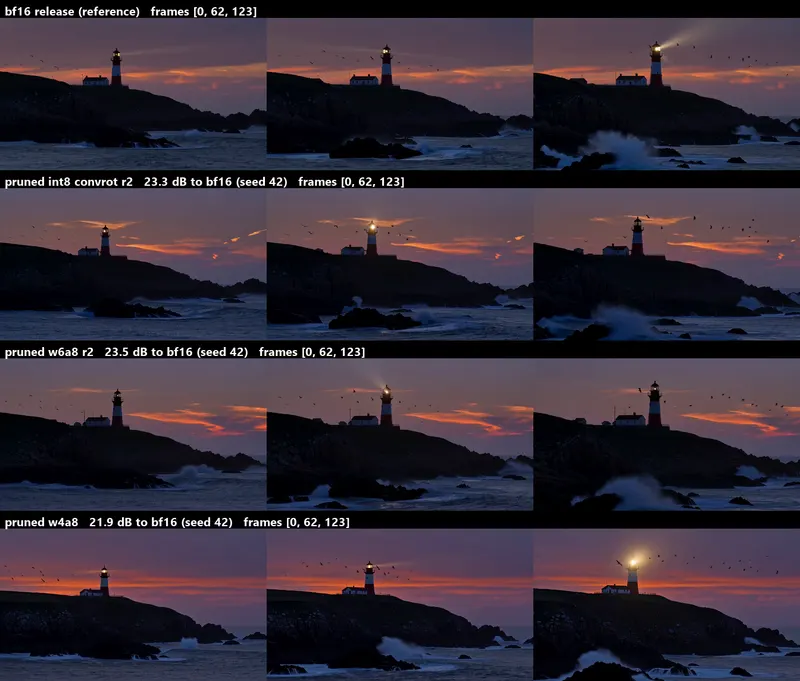
Image : blog.comfy.org
ComfyUI

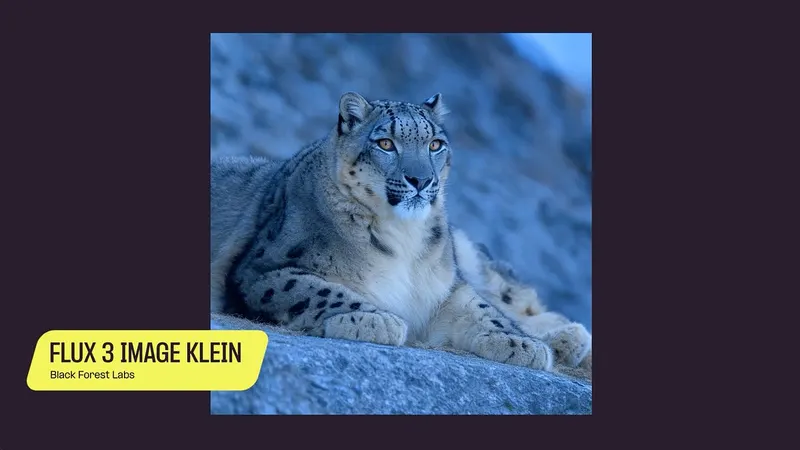
FLUX 3 Image Klein tourne en natif dans ComfyUI avec 5,6 Md de paramètres en poids ouverts

Le modèle FLUX 3 compact et à poids ouverts de Black Forest Labs sort en version de base et en version distillée. Il gère la mise en page par boîtes englobantes, l’édition multi-références et le rendu de texte. Comfy annonce une génération en 1024 px de 4,3 à 9,3 fois plus rapide grâce à la quantification INT8 avec le modèle distillé en étapes.

Source : Blog Comfy

Image : blog.comfy.org
ComfyUI

Comfy Org lance un challenge open source doté de 25 000 $

Higgsfield avait promis d’ouvrir le code de sa plateforme : Comfy invite donc les développeurs à créer des versions ouvertes d’outils comme Genjutsu et Cinema Studio sur la Comfy Developer Platform. Le challenge dure deux semaines, avec un grand prix de 10 000 $ et trois RTX 5090 à gagner. Runpod, LTX, BFL et MiniMax le soutiennent.

Source : Blog Comfy

Image : blog.comfy.org
ComfyUI

Krea 3 arrive dans ComfyUI en nœud partenaire

Un seul nœud gère à la fois le text-to-image et l’édition avec Krea 3, avec jusqu’à 8 images de référence en 1K ou 2K. Il est disponible depuis la v0.41.1.

Source : Blog Comfy

Image : civitai.com
Civitai

HeyGen Video arrive dans le générateur Civitai, avec le son intégré

Premier modèle vidéo généraliste de HeyGen, il gère le text-to-video, l’image-to-video et la vidéo à partir de références, et produit des clips de 5 à 15 s dont les dialogues, l’ambiance et les effets sonores sont générés en une seule passe. Il est à -50 % jusqu’à fin octobre.

Source : Article Civitai

Image : huggingface.co
Modèles

Poids de FLUX 3 Image Klein : 5,6 Md de paramètres, checkpoints distillé et Base

Black Forest Labs a publié FLUX 3 Image Klein sur Hugging Face : un modèle de 5,6 Md de paramètres pour le text-to-image, l’édition à partir d’une référence et la composition multi-références (jusqu’à 10 images), avec Qwen3-VL-4B-Instruct comme encodeur de texte. Le checkpoint distillé tourne en 16 étapes sans guidance ; Klein Base (50 étapes, guidance 3,5) sert au fine-tuning et à l’entraînement de LoRA. Fichiers BF16, FP8 et NVFP4 inclus.

Modèle de baseBase : FLUX 3 (nouvelle base)Licence : FLUX Kommunity License (accès sur demande)

À noter : La fiche indique qu’un « prompt upsampler » est indispensable : un prompt court donne un résultat générique. Date = création du dépôt Hugging Face.

Source : Fiche du modèle sur Hugging Face

Image : huggingface.co
Modèles

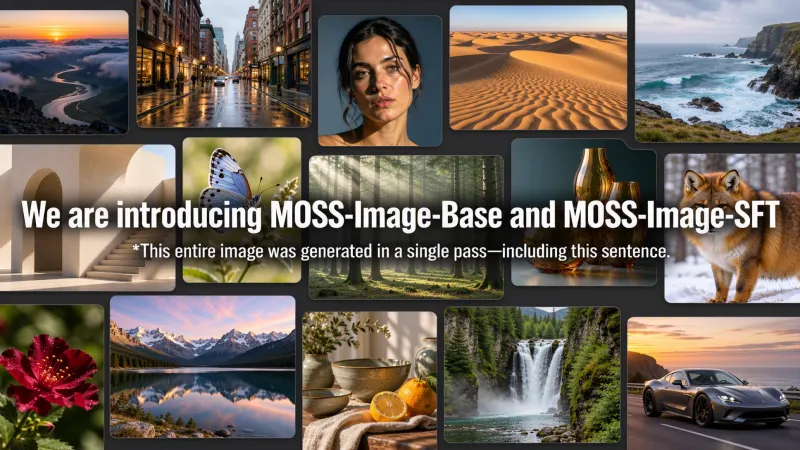
MOSS-Image Base et SFT : des poids text-to-image sous Apache 2.0

OpenMOSS a publié deux checkpoints text-to-image à poids ouverts, MOSS-Image-Base et MOSS-Image-SFT (affiné), sous licence Apache 2.0, avec prise en charge de Diffusers et une démo en ligne. C’est l’un des dépôts text-to-image les plus en vogue sur Hugging Face, et les premiers fine-tunes et LoRA de la communauté apparaissent déjà.

Modèle de baseBase : MOSS-Image (nouvelle base)Licence : Apache 2.0

Source : Fiche du modèle sur Hugging Face

Modèles

DaSiWa MiniMax H3 Hybrid v4 : un checkpoint vidéo communautaire

Le checkpoint MiniMax H3 affiné par Darksidewalker passe en Hybrid v4, compatible avec les workflows référence vers vidéo (REF2VA) et première/dernière image (FL2VA), avec une variante Turbo en 4 étapes. C’est le checkpoint MiniMax H3 le mieux classé dans les téléchargements mensuels de Civitai.

Checkpoint vidéoBase : MiniMax H3Licence : non précisée

À noter : Pas d’image : aucune image d’aperçu de la v4 n’est classée tout public sur Civitai. Les améliorations annoncées par l’auteur (qualité, audio, mouvement) n’ont pas été testées de façon indépendante.

Source : Page du modèle sur Civitai
Image : huggingface.co
Modèles

Qwen-Image-2.1-Turbo : génération et édition en 8 étapes

Qwen a publié un checkpoint accéléré de Qwen-Image-2.1 pour le text-to-image et l’édition d’images en 8 étapes de débruitage. Il garde la même architecture de 7 Md de paramètres, se charge avec QwenImage21Pipeline dans Diffusers, embarque son propre planning d’échantillonnage et utilise CFG 1 par défaut.

CheckpointBase : Qwen-Image-2.1Licence : Licence Qwen Research

À noter : La licence Qwen Research n’est pas une licence open source standard : vérifiez ses conditions avant tout usage commercial.

Source : Fiche du modèle sur Hugging Face

Image : huggingface.co
Modèles

Veda apporte une attention clairsemée apprise à MiniMax-H3 en référence vers vidéo

Veda est un prédicteur d’attention clairsemée appris pour la diffusion vidéo. Cette préversion l’applique à la génération audio-vidéo à partir de références de MiniMax-H3, avec la LoRA Turbo de H3 pour 8 étapes. Ce n’est pas une LoRA : le modèle de base reste inchangé, et le prédicteur est stocké en FP8.

Module vidéoBase : MiniMax-H3Licence : MiniMax H3 Community License

À noter : Préversion, affinée sur seulement 600 itérations selon la fiche.

Source : Fiche du modèle sur Hugging Face

Image : civitai.com
Civitai
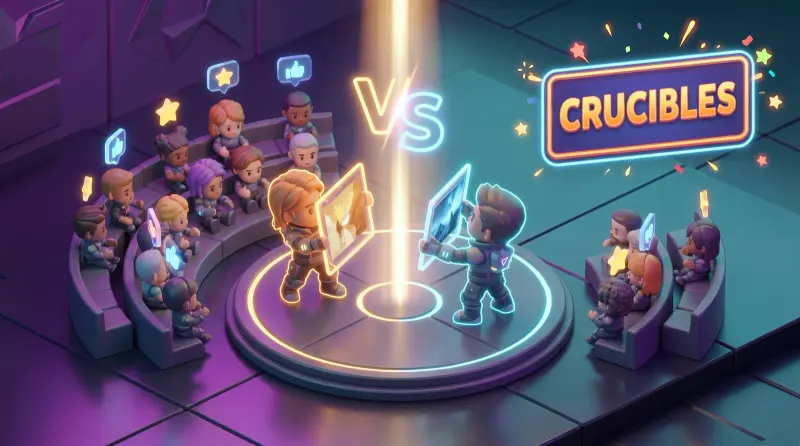
Crucibles : des duels où la communauté désigne le gagnant

Les votants comparent deux participations à la fois, et la cagnotte se compose de la mise initiale de l’organisateur et de tous les frais d’inscription (de 10 à 1 000 Buzz). Organiser un concours exige un Creator Score de 5 000, et les concours durent 24 heures, 3 jours ou 7 jours.

Source : Article Civitai
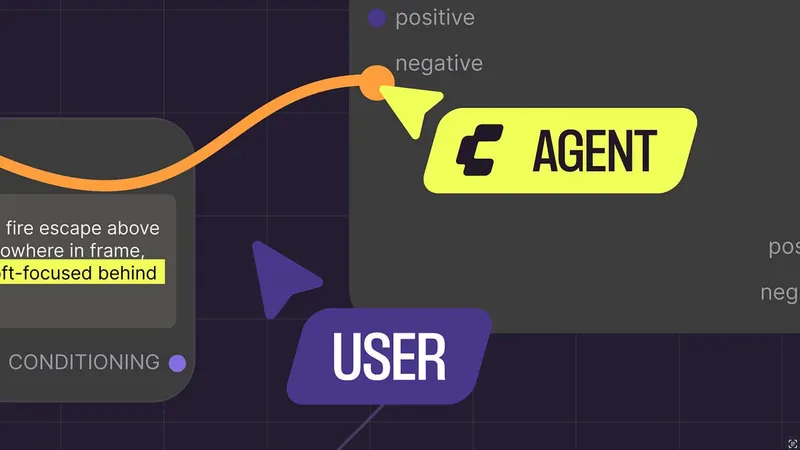
Image : blog.comfy.org
ComfyUI

Comfy Agent arrive dans Comfy Cloud

Un agent intégré qui planifie, construit, exécute et corrige des workflows ComfyUI à partir de demandes en langage naturel. On peut l’essayer avec des Comfy Credits, et Comfy annonce son arrivée dans Comfy Desktop « d’ici quelques semaines ».

À noter : Pas encore confirmé : la disponibilité dans Comfy Desktop n’avait pas été annoncée au 26/10/2026.

Source : Blog Comfy

Image : civitai.com
civitai.red

Contexte : ce qu’est civitai.red

Depuis le 15 avril 2026, civitai.com est le site SFW de Civitai (paiement par carte, abonnements, Creator Program), et civitai.red est le site « freedom-first » qui affiche tous les contenus, NSFW compris, et accepte les paiements en crypto. Les deux sites partagent les mêmes comptes et contenus, et civitai.green redirige (301) vers civitai.com.
À noter : Article de contexte d’avril 2026, hors de la période d’actualité couverte. La redirection de civitai.green vers civitai.com a été revérifiée le 26/10/2026.

Source : Article Civitai